REA : j’ai testé la rétro-ingénierie pilotée par l’IA avec Claude Code
Comprendre le fonctionnement d'un programme dont vous n'avez que l'exécutable ou le binaire, en posant simplement la question en français à un agent IA : c'est la promesse de REA, le projet qui affole GitHub depuis quelques semaines. S'il attire autant de monde, c'est aussi parce qu'il permet de recréer, je dirais même de cloner, n'importe quel logiciel.
REA, pour Reverse Engineer Anything, est un outil de rétro-ingénierie pilotée par l'IA : il permet à un agent comme Claude Code ou Codex de piloter de vrais outils d'analyse de binaires, à commencer par Ghidra. Le projet cumule près de 395 000 étoiles sur GitHub fin octobre 2026 (et quand cet article sera publié, il aura surement dépassé la barre des 400 000 étoiles), ce qui en fait l'un des dépôts les plus suivis du moment.
Alors, simple effet de mode ou réelle avancée pour le reverse engineering ? Parlons-en. Dans cet article, je vous propose de revenir sur ce qu'est la rétro-ingénierie, puis de découvrir REA et son fonctionnement en tant que serveur MCP. Par la suite, nous verrons ce que la communauté en fait, ce que dit la loi française sur la décompilation, comment installer REA sous Linux avec Ghidra, et enfin le résultat d'une démonstration complète sur le jeu Moon-Buggy, jusqu'à sa recréation en version web.
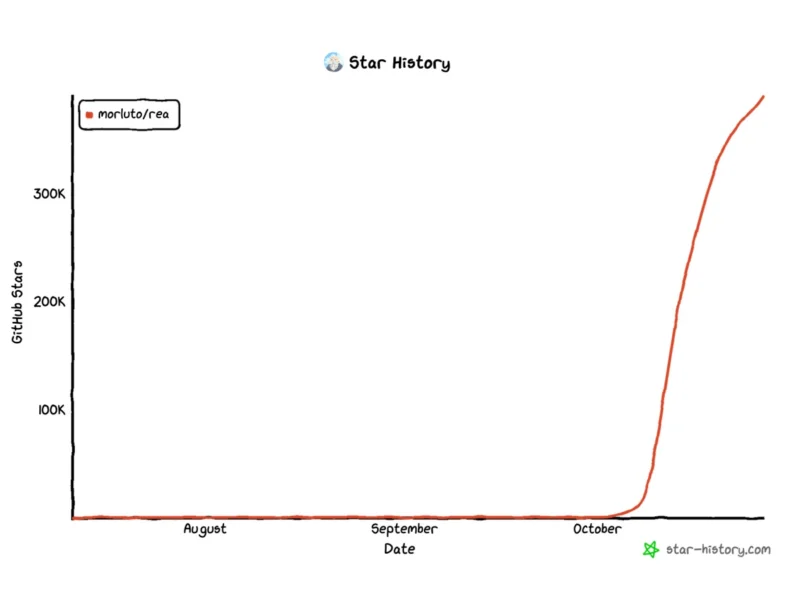
En bref : REA (Reverse Engineer Anything) est un serveur MCP open source, sous licence MIT, qui permet à un agent IA (Claude Code, Codex, Cursor, Gemini CLI, etc.) de piloter des outils de rétro-ingénierie comme Ghidra, IDA ou Hopper. L'agent analyse un programme sans son code source et justifie chaque conclusion par des preuves : adresse, instruction ou constante lue dans le binaire.
Qu'est-ce que la rétro-ingénierie ?
Du code source au binaire, puis le chemin inverse
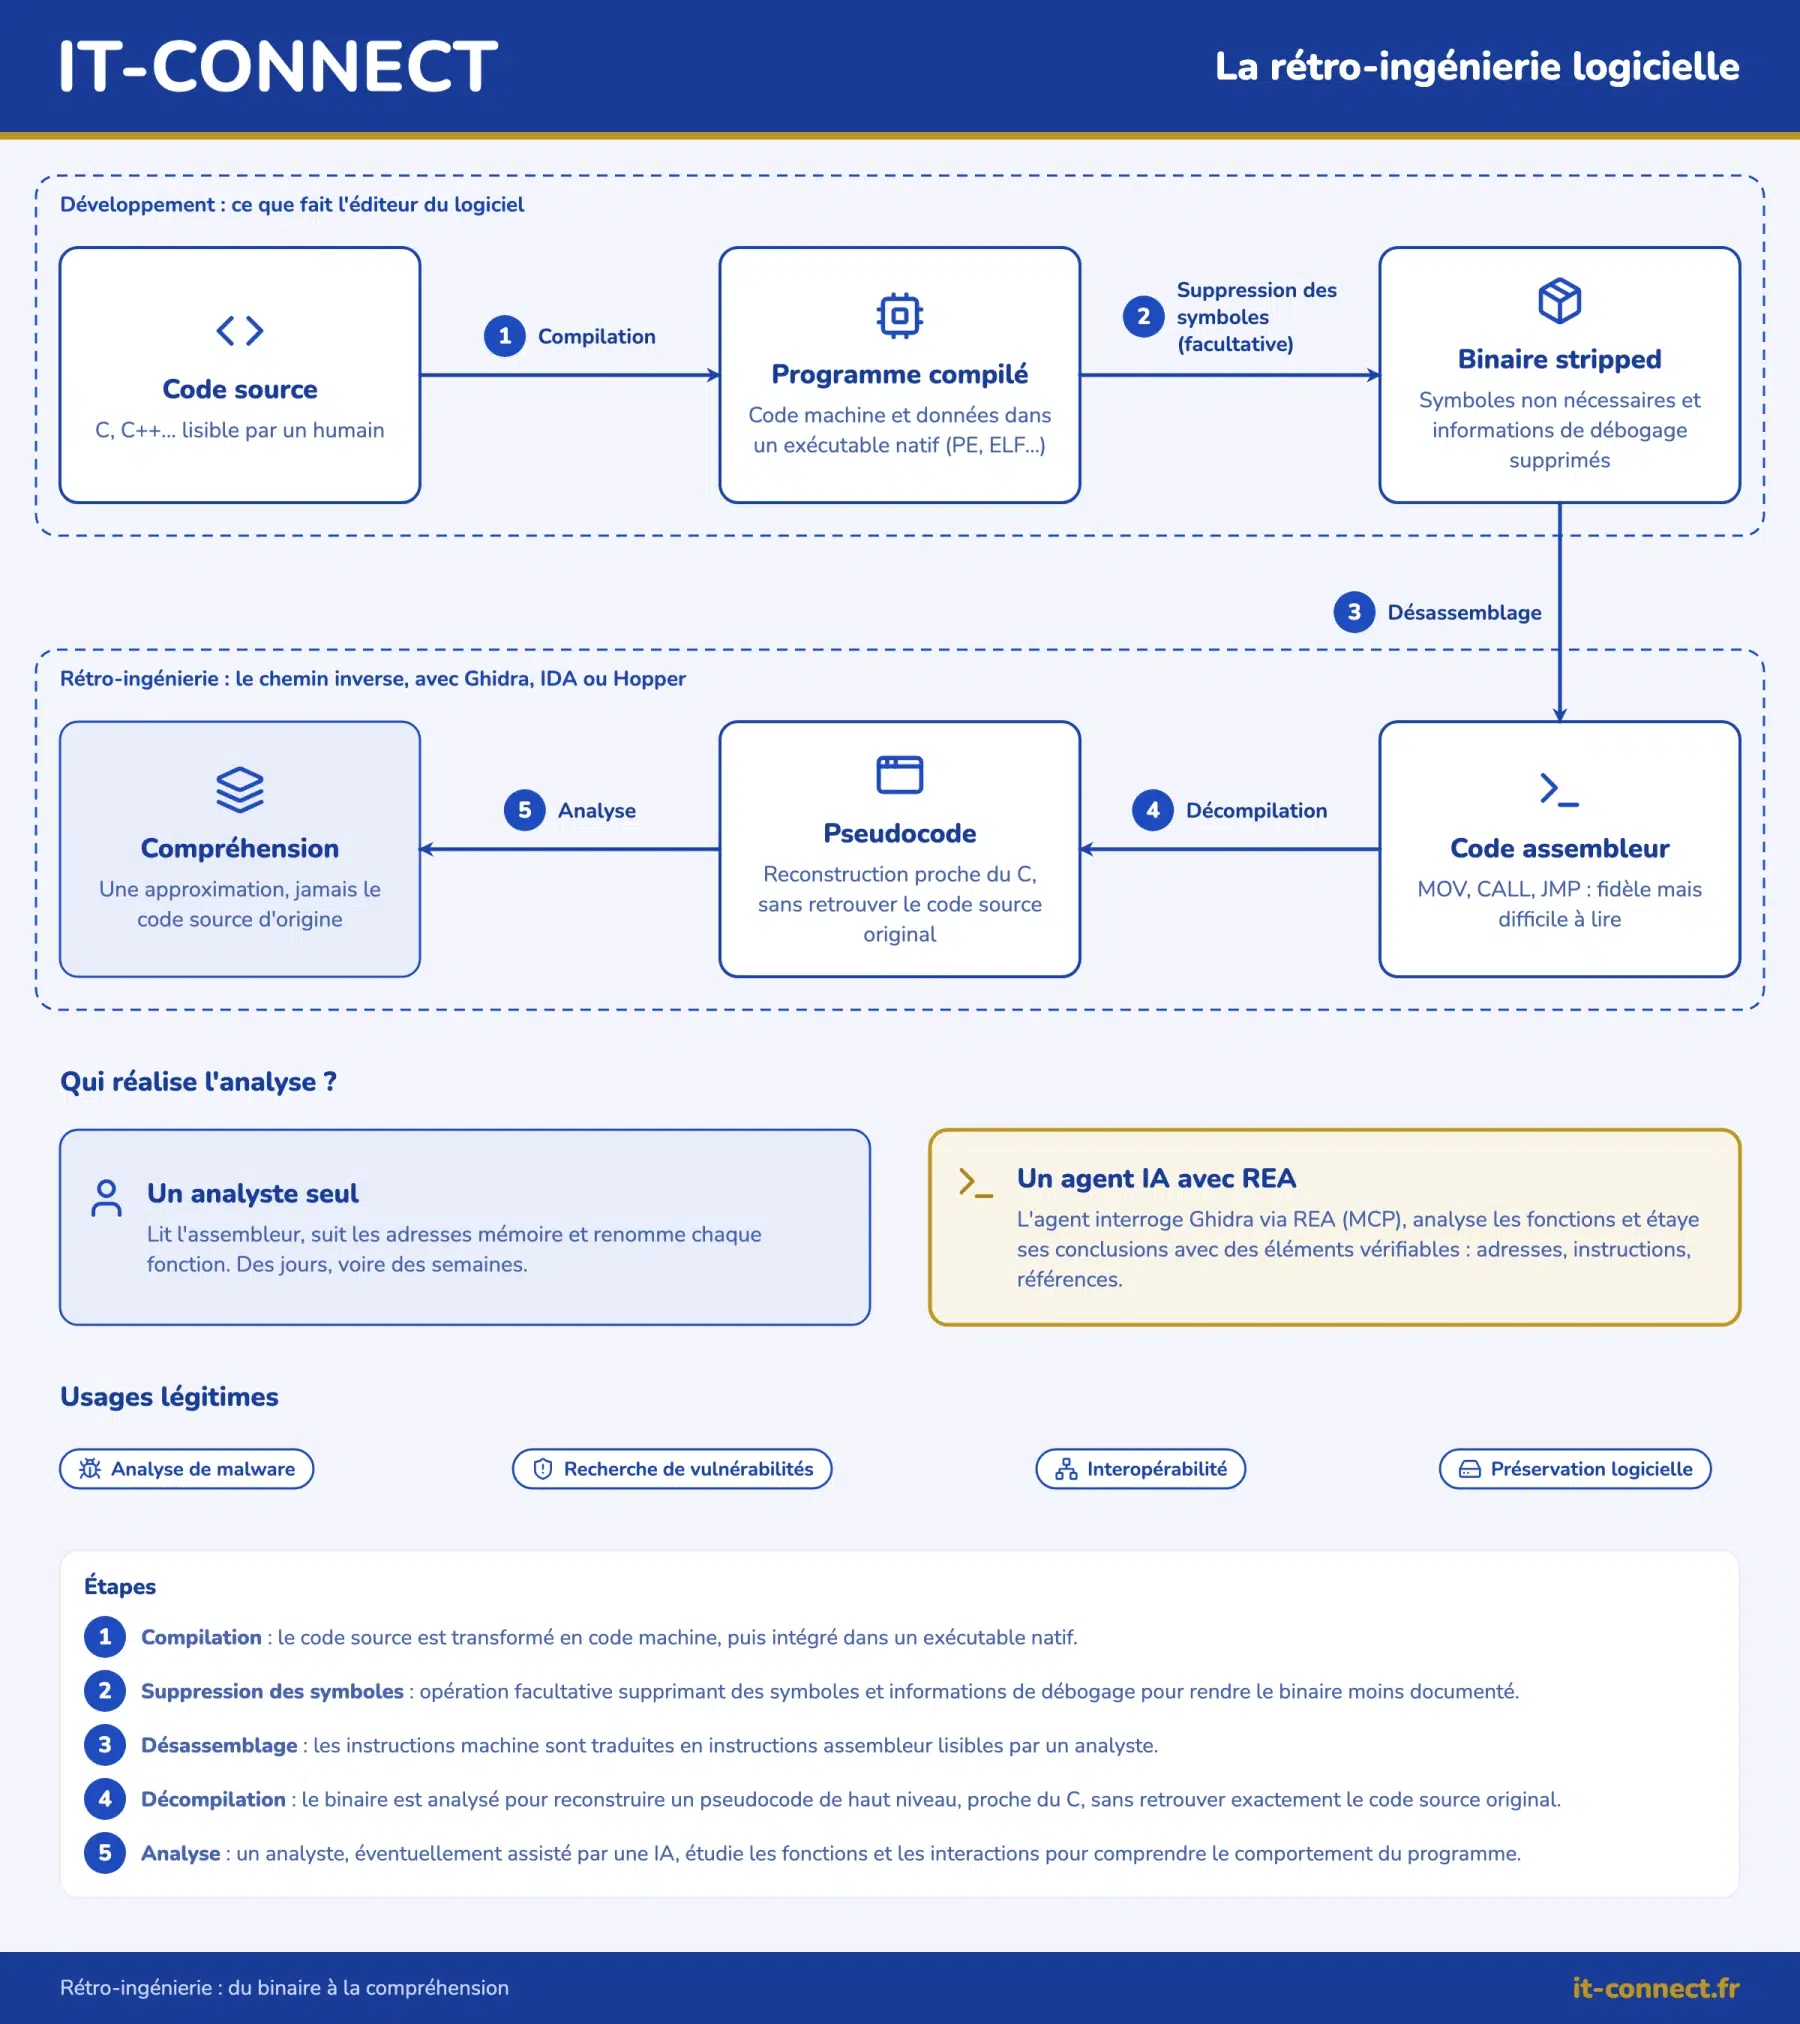
Quand un développeur crée un logiciel, il écrit du code source : du texte lisible par un humain, dans un langage comme le C, le C++ ou le C#. Ce code passe ensuite dans un compilateur qui le traduit en instructions compréhensibles par le processeur. C'est ce résultat, le binaire, que vous récupérez en tant qu'utilisateur : un fichier .exe sous Windows, un exécutable ELF sous Linux, etc.
La rétro-ingénierie (ou reverse engineering en anglais) consiste à faire le chemin inverse. On part du programme compilé et on cherche à comprendre ce qu'il fait et comment il le fait. Il faut toutefois garder une chose à l'esprit : on ne retrouve jamais le code source d'origine. Les noms des fonctions et des variables ont souvent disparu, les commentaires aussi. On obtient une approximation, qu'il faut ensuite interpréter.
Deux opérations reviennent souvent dans ce domaine :
Le désassemblage : traduire le code machine en instructions assembleur (
MOV,CALL,JMP, etc.), une représentation fidèle mais difficile à lire.La décompilation : reconstruire un pseudocode proche d'un langage de haut niveau comme le C, plus lisible, mais qui reste une interprétation du binaire.
Un travail long et minutieux
C'est là que les choses se compliquent : il faut lire de l'assembleur (de quoi en refroidir plus d'un, je vous assure), suivre des adresses mémoire, deviner le rôle de chaque fonction et renommer les éléments au fur et à mesure. C'est un véritable métier, en particulier dans la cybersécurité, que ce soit pour analyser un malware, rechercher une vulnérabilité ou vérifier le comportement d'un logiciel tiers. Et c'est un travail qui peut prendre des jours, voire des semaines, pour un seul programme.
C'est justement ce que REA cherche à accélérer, et à rendre accessible au plus grand nombre.
REA : un serveur MCP pour piloter la rétro-ingénierie avec l'IA
Ce que fait REA
Contrairement à ce que l'on pourrait croire, REA n'est pas un nouveau décompilateur. REA est un serveur MCP : une passerelle qui permet à un agent IA de piloter des outils de rétro-ingénierie existants, et de les combiner selon la cible à analyser.
Qu'est-ce qu'un serveur MCP ? Le Model Context Protocol (MCP) est un protocole ouvert qui standardise la façon dont un agent IA accède à des outils et à des données externes. Un serveur MCP expose des « outils » que l'agent peut appeler : ici, des fonctions pour ouvrir un binaire, lister ses chaînes de caractères, décompiler une fonction, suivre des références, etc.
Ce qu'il faut bien comprendre avec REA, c'est qui fait le travail. Avant, c'était vous qui passiez des heures dans Ghidra. Maintenant, vous posez votre question en français à votre agent IA, et c'est lui qui interroge Ghidra, suit les appels de fonctions et lit les valeurs en mémoire avant de vous répondre.
REA s'utilise directement en ligne de commande via votre agent IA préféré, et les analyses s'exécutent en local. Toutefois, il faut bien comprendre que les résultats des outils sont transmis à votre agent, et donc au fournisseur du modèle d'IA (Anthropic, OpenAI, etc.), qui applique sa propre politique de gestion des données.
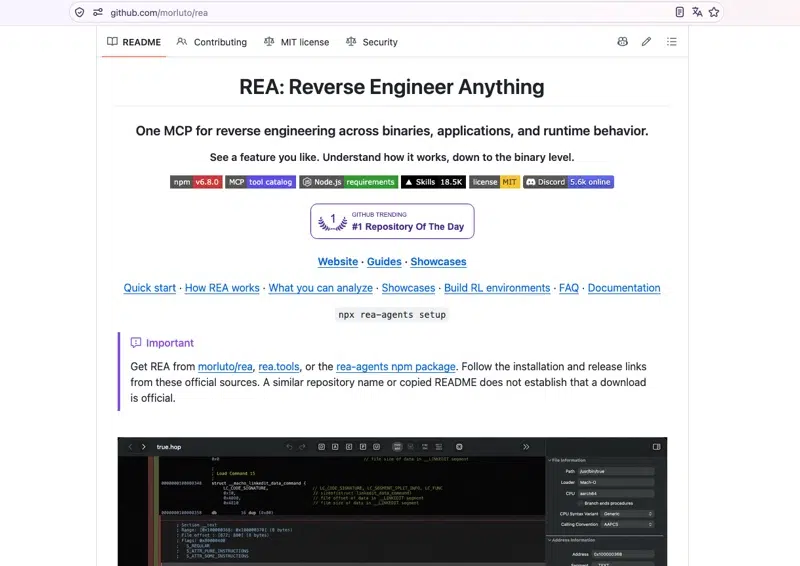
Voici les liens vers les ressources officielles :
Site officiel : rea.tools
Dépôt GitHub : github.com/morluto/rea
Paquet npm : rea-agents
Ghidra, IDA et Hopper : les moteurs d'analyse
Pour l'analyse des binaires natifs, REA s'appuie sur un moteur d'analyse déjà installé sur votre machine. De nombreux outils sont pris en charge et REA va les solliciter en fonction du type d'applications ou de ressources à décortiquer. Voici quelques exemples pour la partie exécutable :
Outil
Modèle
Particularité
Open source, licence Apache 2.0
Désassembleur et décompilateur complet, développé par la NSA (l'agence de renseignement américaine) puis publié en open source
Commercial (Hex-Rays)
Référence historique du reverse engineering en entreprise
Commercial, avec version de démonstration
Surtout utilisé sur macOS
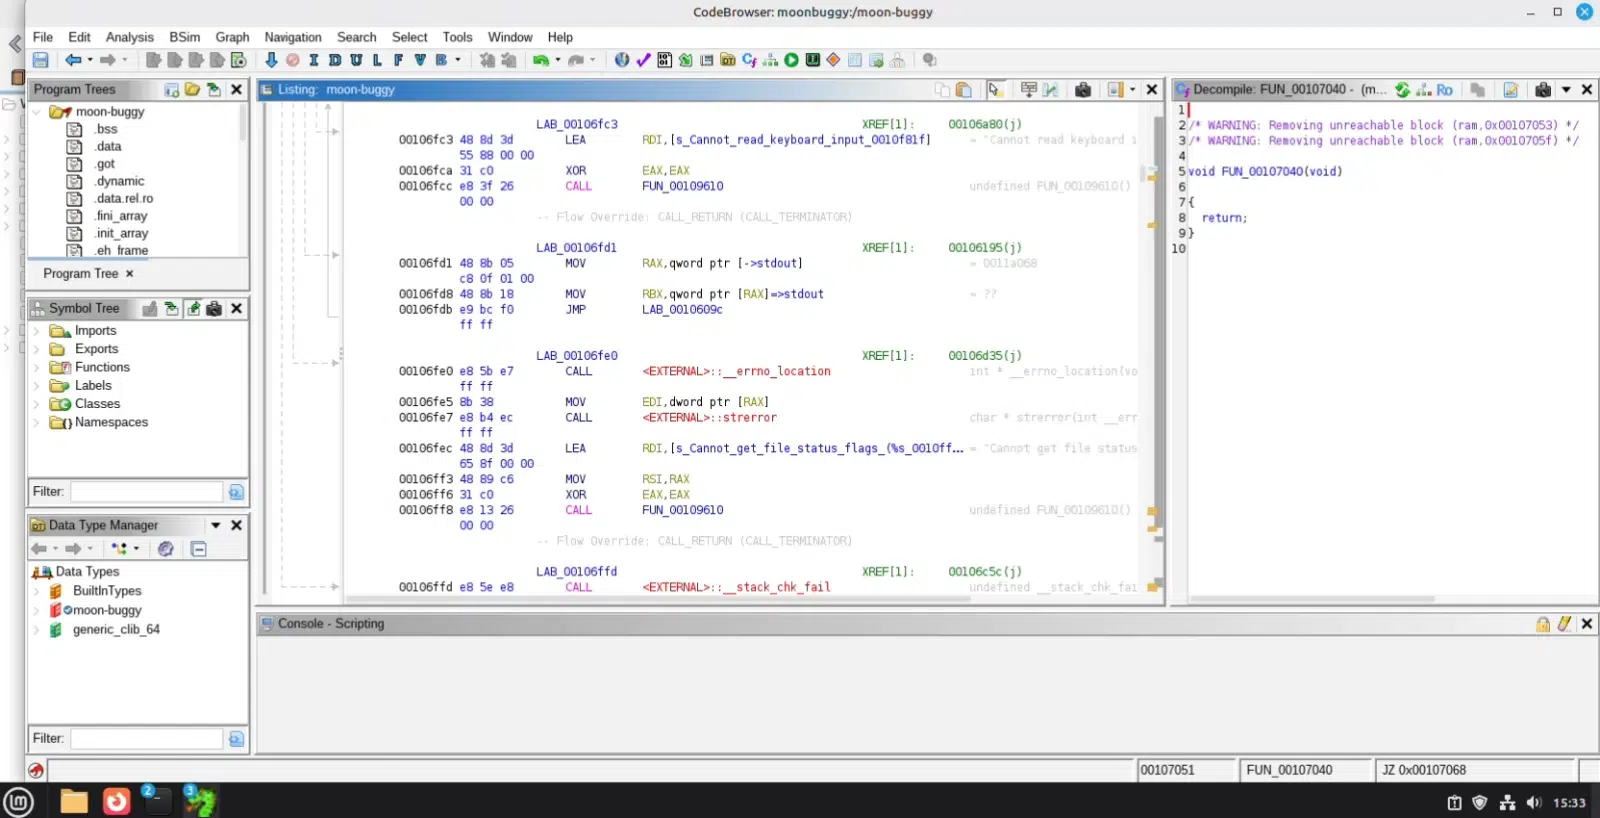
Dans cet article, nous utiliserons Ghidra, qui a l'avantage d'être gratuit et open source. En pratique, Ghidra désassemble un programme et le traduit en pseudocode proche du langage C, dans son interface CodeBrowser.
Note : REA ne fournit aucune licence pour les outils commerciaux. Si vous utilisez IDA ou Hopper, vous devez disposer d'une licence valide.
Des réponses appuyées sur des preuves
Le point le plus intéressant de REA, c'est que chaque réponse s'appuie sur des preuves : une adresse, une instruction, une constante ou une chaîne lue dans le programme. L'IA ne devine pas le fonctionnement du logiciel, elle lit le binaire et vous montre où elle a trouvé l'information. REA signale aussi les zones d'incertitude, ce qui est appréciable pour juger de la fiabilité d'une conclusion.
Le cycle d'une investigation se résume ainsi : vous posez une question sur une cible locale, REA l'inspecte avec les outils d'analyse, renvoie le code, les références et les inconnues, puis l'agent s'en sert pour expliquer, implémenter ou tester. Si besoin, il relance une question de suivi.
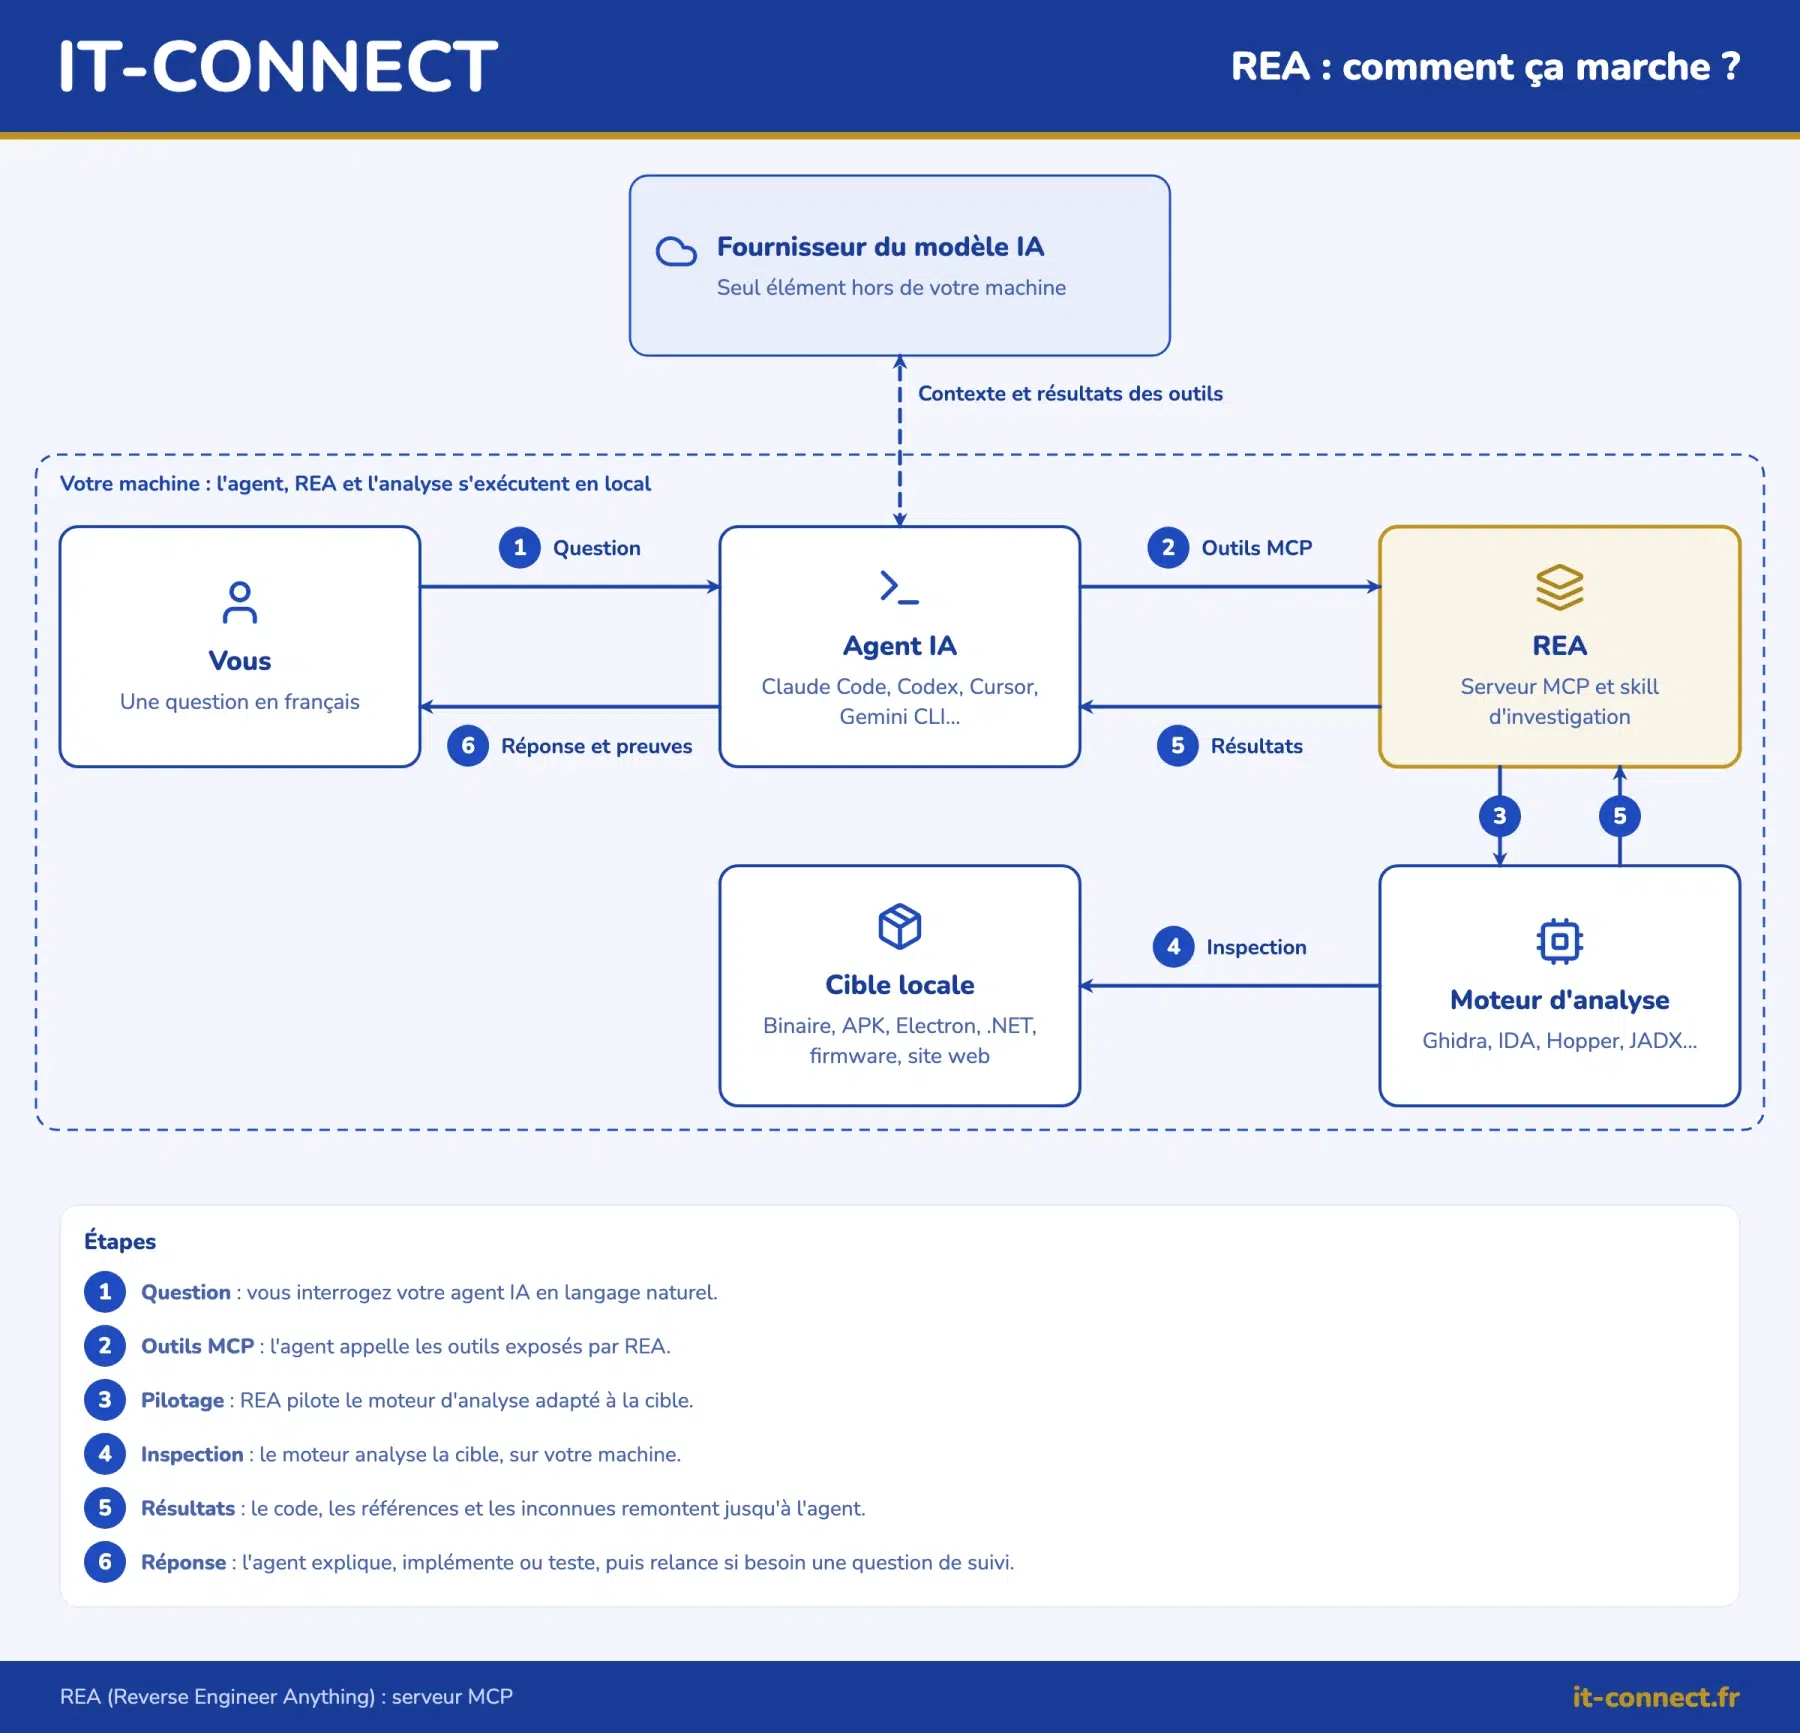
Agents et cibles compatibles
Au moment où j'écris ces lignes, l'assistant d'installation de REA sait configurer 25 agents, dont Claude Code, Claude Desktop, Codex, Cursor, Gemini CLI, ou encore GitHub Copilot CLI. Les autres clients compatibles MCP peuvent être configurés manuellement.
REA ne se limite pas aux exécutables natifs. Parmi les cibles prises en charge, on retrouve notamment :
Les binaires natifs (ELF, PE, Mach-O) via Ghidra, IDA ou Hopper : pseudocode, assembleur, chaînes, symboles, appels et références.
Les applications JavaScript et Electron : modules, imports, source maps, échanges IPC.
Les assemblies .NET : métadonnées et instructions CIL, sans moteur d'analyse supplémentaire.
Les applications Android (APK) via JADX.
Les firmwares via Binwalk ou Unblob sous Linux.
Les sites web via un navigateur de la famille Chrome.
Les captures réseau (HAR, pcap) et d'autres formats plus spécifiques.
Ce que la communauté fait avec REA
Depuis sa sortie, la communauté s'est emparée de REA. Ce projet affole littéralement la toile... Il suffit de regarder sur les réseaux sociaux, beaucoup de personnes en parlent ! Il y a donc beaucoup d'exemples de ce que l'on peut faire avec... En voici trois qui illustrent bien la variété des usages.
DX-Ball : reconstruire un casse-briques de 1996 en C
DX-Ball est un casse-briques sorti sur Windows en 1996. Le projet dx-ball vise à le reconstruire en C/C++ lisible, fonction par fonction, à partir de l'exécutable original. Son auteur utilise l'agent Codex avec REA, qui interroge Ghidra pour récupérer chaque fonction. Le code reconstruit est ensuite recompilé avec le compilateur d'origine, comparé à l'original, puis affiné jusqu'à obtenir le même code machine.
Actuellement, les 270 fonctions reconstruites produisent un code machine identique à l'original, et l'exécutable recompilé fonctionne sous Wine, avec encore quelques validations en cours. Ce cas d'usage fait d'ailleurs partie des études de cas officielles de REA.
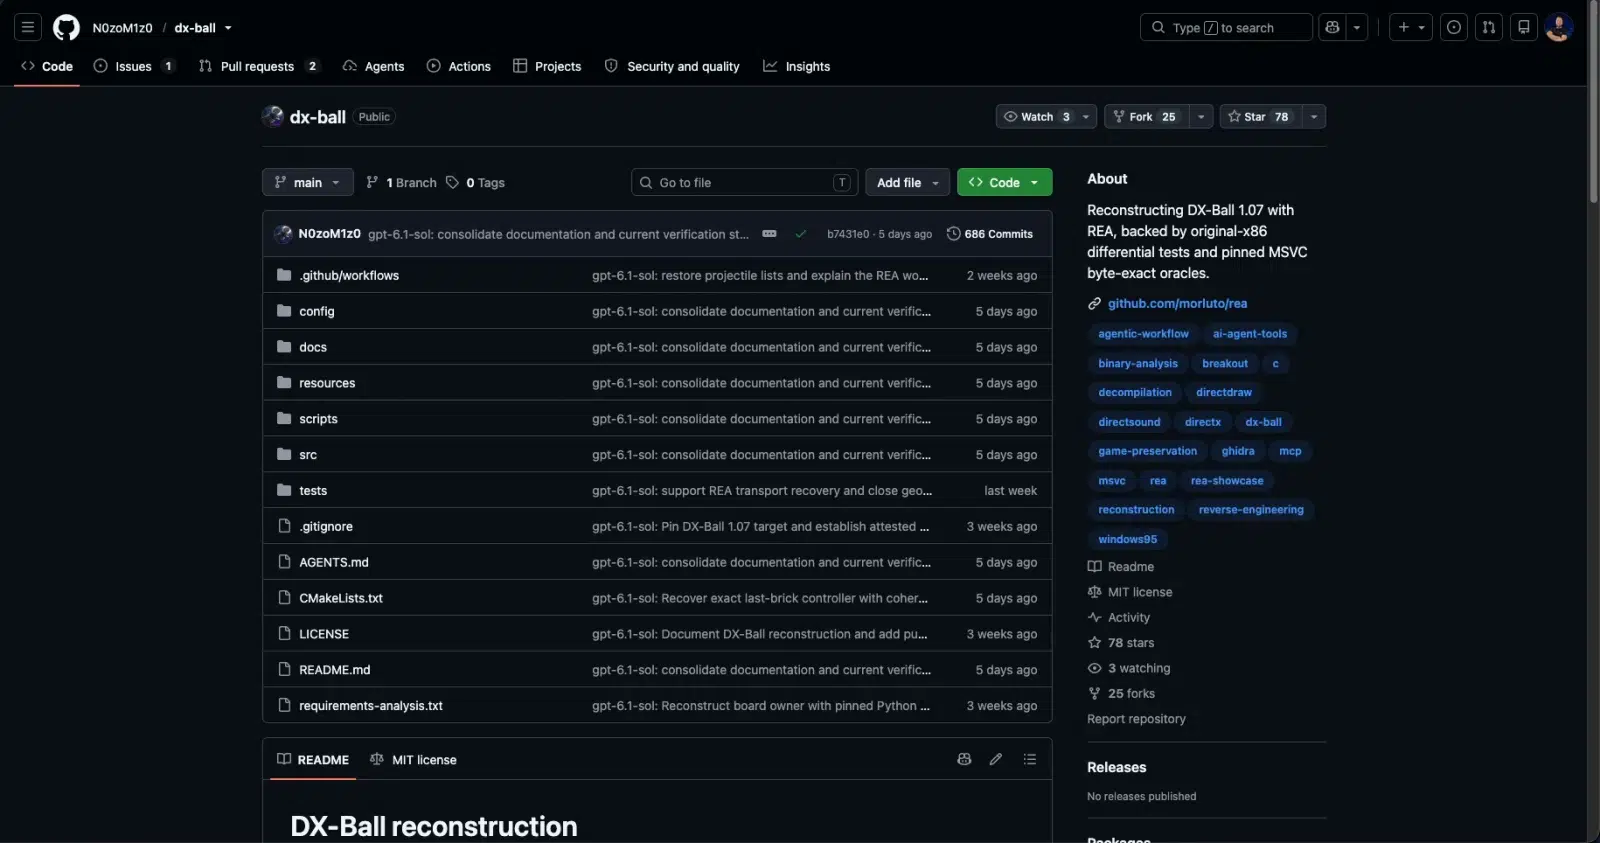
ReaCut : s'inspirer de CapCut pour créer un éditeur vidéo open source
Le projet ReaCut est un éditeur vidéo open source. Son auteur a utilisé REA pour étudier l'interface et le format des projets de Jianying, la version chinoise de CapCut. À partir de cette analyse, il a développé son propre éditeur, implémenté de façon indépendante.
J'en profite pour mentionner une subtilité essentielle : ReaCut ne copie pas le code de CapCut. Autrement dit, le projet s'inspire du fonctionnement de l'application pour le reproduire.
VSL-DSP : redonner vie à des cartes son sous Linux
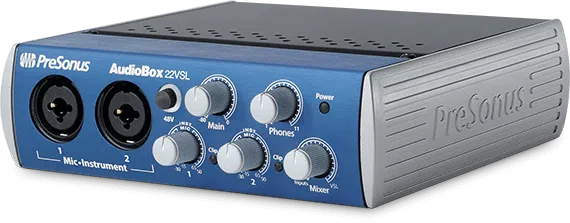
REA peut aussi vous aider à ressusciter du vieux matériel, c'est d'ailleurs un cas d'usage particulièrement intéressant. Prenez les cartes son PreSonus AudioBox VSL : sous Linux, le son fonctionne grâce au pilote USB audio générique, mais il est impossible de régler le DSP intégré à la carte.
Le projet VSL-DSP s'attaque à ce problème et se présente comme le seul pilote libre pour ces cartes. Pour décoder une partie du protocole du constructeur, son auteur s'est appuyé sur REA et Ghidra afin d'analyser les bibliothèques de l'application de contrôle officielle.
Ce que je dis à propos des vieux appareils est aussi valable pour les logiciels non pris en charge. Imaginez un vieux logiciel compatible uniquement avec Windows XP et dont l'éditeur a mis la clé sous la porte : REA offre l'opportunité de le recréer et de le rendre compatible avec une version plus récente.
AwesomeREA : un annuaire pour aller plus loin
Il existe beaucoup d'autres exemples. Notez d'ailleurs qu'il est aussi possible de faire de la rétro-ingénierie avec un agent comme Claude sans REA, c'est-à-dire sans outillage spécifique.
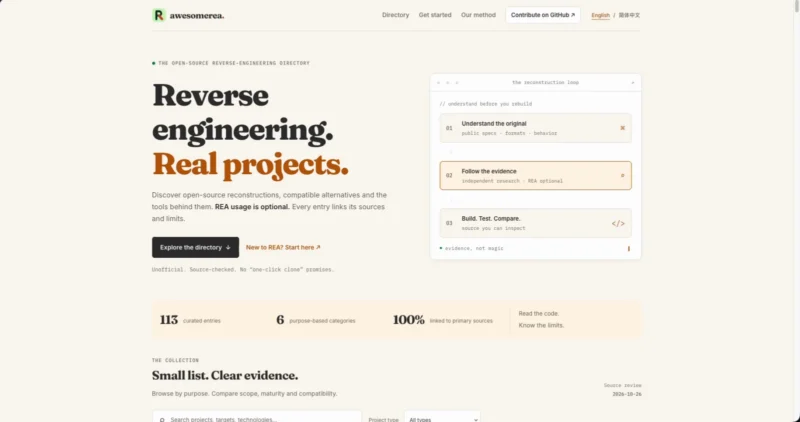
Si vous voulez découvrir d'autres projets, vous pouvez consulter l'annuaire AwesomeREA. Il référence plus d'une centaine de projets, classés par catégorie. Pour chaque projet, il précise si REA a réellement été utilisé ou non. Car en matière de rétro-ingénierie, ce n'est pas toujours le cas : certains projets ont été réalisés à la main pendant des années, comme OpenLara, un moteur open source pour les premiers Tomb Raider.
Rétro-ingénierie et cadre légal en France
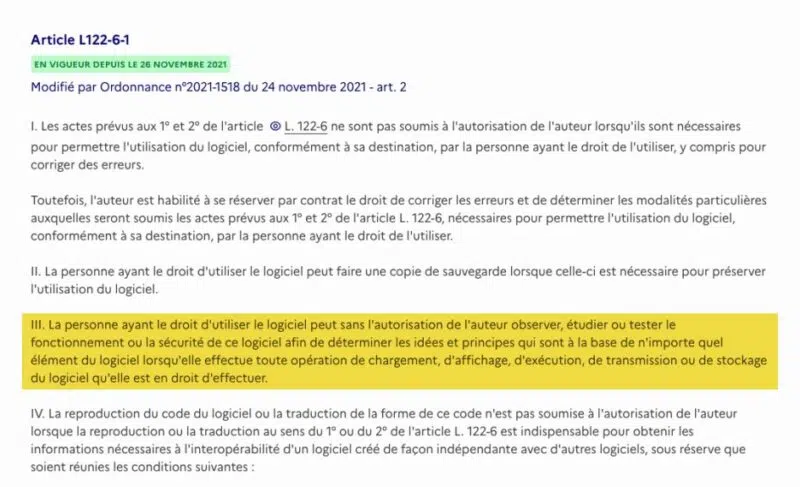
Toutes ces possibilités posent une question légitime : a-t-on le droit de faire ça ? Je ne suis pas juriste, mais en France, une réponse se trouve dans l'article L122-6-1 du Code de la propriété intellectuelle, qui est assez clair sur deux points.
Observer, étudier et tester : la personne qui a le droit d'utiliser un logiciel peut, sans l'autorisation de l'auteur, observer, étudier ou tester son fonctionnement ou sa sécurité, afin de déterminer les idées et principes qui sont à la base de ses éléments (point III de l'article).
Décompiler : la reproduction ou la traduction du code n'est autorisée que si elle est indispensable pour obtenir les informations nécessaires à l'interopérabilité d'un logiciel créé de façon indépendante, c'est-à-dire pour le faire fonctionner avec d'autres logiciels (point IV). Et ce, sous conditions : ces informations ne doivent pas déjà être facilement accessibles, et les actes doivent se limiter aux parties du logiciel nécessaires à cette interopérabilité.
Surtout, le texte précise que les informations obtenues ne peuvent pas être utilisées pour la mise au point, la production ou la commercialisation d'un logiciel dont l'expression est substantiellement similaire, ni communiquées à des tiers en dehors de ce cadre.
Pour résumer : vous avez le droit de chercher à comprendre comment fonctionne un logiciel que vous utilisez légitimement. En revanche, le décompiler pour le cloner et le revendre, ce n'est pas autorisé. Le projet REA va dans ce sens. La page DISCLAIMER évoque un usage responsable et liste ce qu'il ne soutient pas : contournement de DRM, de vérifications de licence ou d'anti-triche, développement de cheats, copie de logiciels propriétaires ou de leur code protégé, etc. Il rappelle aussi que l'utilisateur reste responsable de ce qu'il demande à l'agent d'exécuter.
Soyons honnêtes : en rendant la rétro-ingénierie plus accessible, REA facilite indirectement la copie de logiciels. Mais il existe de nombreux usages légitimes : comprendre le fonctionnement d'un fichier suspect, faire fonctionner du vieux matériel sous Linux, ou encore récupérer la logique d'un vieil outil dont l'éditeur a disparu depuis longtemps.
Ce débat sur le « clonage » de logiciels par l'IA n'est d'ailleurs pas propre à REA, comme le montrent les projets de réécriture des suites Adobe et Microsoft Office en Rust avec des agents Claude. Ce qui est certain, c'est que des outils comme REA facilitent grandement la tâche grâce à l'IA.
Installer REA sur Linux avec Ghidra
Note : pour rester dans un cadre légal, j'ai choisi un logiciel open source pour la démonstration qui suit. Ses sources étant publiques, il n'y a aucun secret à protéger, et cela ne m'empêche pas de travailler uniquement sur le binaire pour voir ce que REA est capable d'en tirer.
Prérequis
Pour cette démonstration, j'utilise une machine virtuelle sous Linux Mint, sur laquelle Claude Code est déjà installé. Si ce n'est pas votre cas, suivez d'abord notre tutoriel installation et utilisation de Claude Code.
Voici ce dont REA a besoin pour analyser des binaires natifs avec Ghidra :
Node.js et npm : REA exige Node.js 22.x (22.23.4 minimum), 24.x (24.22.1 minimum) ou 26.12.1 et supérieur.
Ghidra 12.1 ou supérieur, avec un JDK 64 bits complet. La combinaison utilisée ici est Ghidra 12.1.4 avec le JDK 21.
Une commande
pscompatible procps dans lePATH(c'est le cas par défaut sur Debian, Ubuntu et leurs dérivées).Un agent IA compatible, ici Claude Code.
Attention à la version de Ghidra : si vous souhaitez utiliser une version plus récente, vérifiez tout d'abord la prise en charge dans la documentation d'installation de REA.
Installer Node.js 24 avec NodeSource
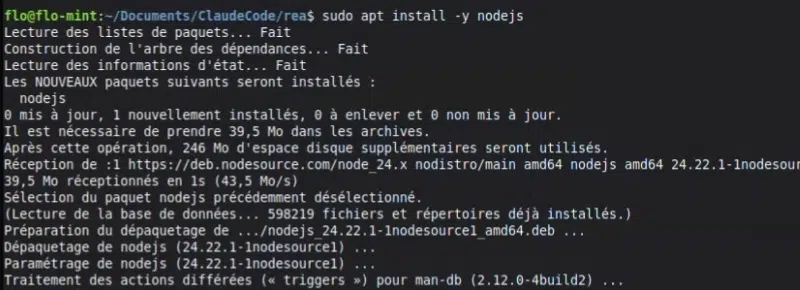
La première étape consiste à installer Node.js. Nous allons utiliser directement le dépôt NodeSource, qui fournit les versions récentes de Node.js.
# Ajouter le dépôt NodeSource pour la branche Node.js 24.x
curl -fsSL https://deb.nodesource.com/setup_24.x | sudo -E bash -

# Installer Node.js (npm est inclus dans le paquet)
sudo apt install -y nodejs

# Vérifier la version installée (24.22.1 ou supérieure)
node -v
Dans mon cas, c'est la version 24.22.1 de Node.js qui a été installée.
Installer Ghidra 12.1.4 et Java 21
La deuxième étape, c'est l'installation de Ghidra et de Java. Nous installons le JDK 21 depuis les dépôts de la distribution, puis nous récupérons l'archive de Ghidra 12.1.4 depuis le dépôt GitHub officiel de Ghidra.
# Installer le JDK 21 et l'utilitaire unzip
sudo apt install -y openjdk-21-jdk unzip

# Télécharger Ghidra 12.1.4 depuis le dépôt officiel
cd /tmp
wget https://github.com/NationalSecurityAgency/ghidra/releases/download/Ghidra_12.1.4_build/ghidra_12.1.4_PUBLIC_20260921.zip

# Décompresser Ghidra dans /opt
sudo unzip -q ghidra_12.1.4_PUBLIC_20260921.zip -d /opt
Ensuite, nous déclarons deux variables d'environnement pour indiquer à REA où se trouvent Ghidra et Java :
# Chemin d'installation de Ghidra
echo 'export GHIDRA_INSTALL_DIR=/opt/ghidra_12.1.4_PUBLIC' >> ~/.bashrc

# Chemin du JDK 21
echo 'export JAVA_HOME=/usr/lib/jvm/java-21-openjdk-amd64' >> ~/.bashrc

# Recharger la configuration du shell
source ~/.bashrcGHIDRA_INSTALL_DIR: indique le répertoire racine de Ghidra. Cette variable est prioritaire sur toute autre méthode de détection.JAVA_HOME: indique le JDK à utiliser. Elle est facultative sijavaetjavacsont dans lePATH, mais elle évite toute ambiguïté lorsque plusieurs JDK sont installés.
Vérifier la configuration avec rea doctor
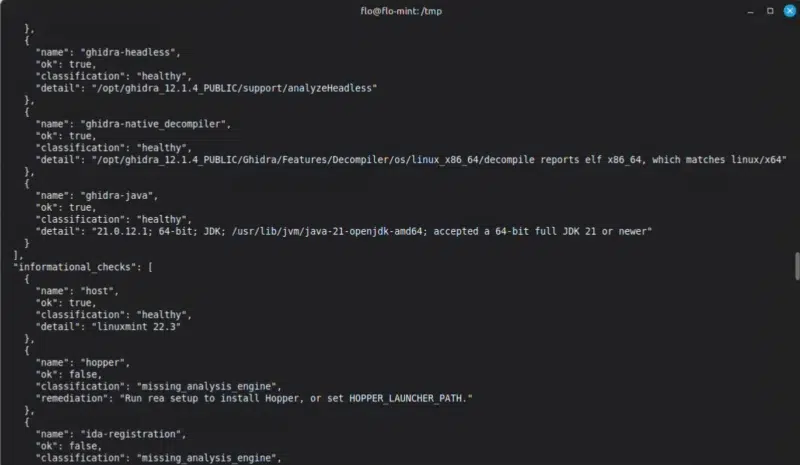
Pour vérifier que tout est en ordre, REA propose une commande de diagnostic : doctor. L'option --provider ghidra limite la vérification au moteur Ghidra, et --json produit un rapport détaillé.
npx rea-agents@latest doctor --provider ghidra --jsonDans le rapport, chaque contrôle doit être classé healthy. Voici un extrait de la sortie obtenue sur ma machine :
{
  "name": "ghidra-native_decompiler",
  "ok": true,
  "classification": "healthy",
  "detail": "/opt/ghidra_12.1.4_PUBLIC/Ghidra/Features/Decompiler/os/linux_x86_64/decompile reports elf x86_64, which matches linux/x64"
},
{
  "name": "ghidra-java",
  "ok": true,
  "classification": "healthy",
  "detail": "21.0.12.1; 64-bit; JDK; /usr/lib/jvm/java-21-openjdk-amd64; accepted a 64-bit full JDK 21 or newer"
}
Ghidra est bien détecté, ainsi que son décompilateur natif et le JDK 21. Les entrées concernant Hopper ou IDA apparaissent en missing_analysis_engine, ce qui est normal puisque nous ne les utilisons pas.
Installer le serveur MCP REA pour Claude Code
La troisième étape, c'est l'installation de REA en lui-même, c'est-à-dire l'enregistrement du serveur MCP auprès de votre agent. Cette commande doit être exécutée dans un terminal classique, et non dans Claude Code :
npx rea-agents@latest setupL'assistant détecte les agents installés sur la machine (ici, Claude Code), vous demande lesquels doivent utiliser REA, puis affiche les modifications prévues avant de les appliquer. Pour Claude Code, il :
Met à jour le fichier
~/.claude.jsonpour y ajouter le serveur MCP REA, après en avoir fait une sauvegarde.Installe une skill
reverse-engineer-anythingdans~/.claude/skills/, qui fournit à l'agent la méthode d'investigation.Reprend les variables détectées (
GHIDRA_INSTALL_DIRetJAVA_HOME) dans la configuration du serveur MCP.
L'assistant précise aussi qu'il n'installe ni ne met à jour Node.js, npm, Java ou Ghidra : c'est à vous de les gérer. Normal.
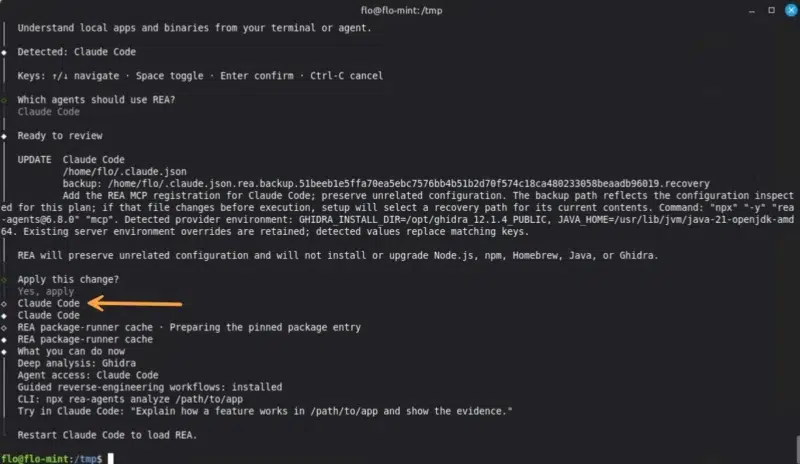
Une fois l'opération terminée, relancez Claude Code pour qu'il charge REA, puis vérifiez que le serveur MCP est bien présent dans la liste :
claude mcp listLa ligne suivante doit apparaître avec l'état Connected :
rea: npx -y [email protected] mcp - ✓ Connected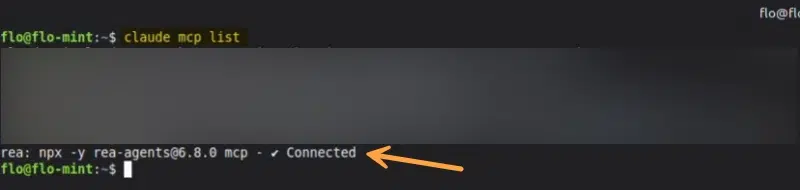
Pour mettre à jour REA par la suite, il suffit de relancer npx rea-agents@latest setup, puis de redémarrer l'agent (par exemple : relancez Claude Code).
Démo : rétro-ingénierie de Moon-Buggy avec Claude Code et REA
Moon-Buggy, un binaire comme terrain de jeu
Pour ce test, j'ai choisi Moon-Buggy, un petit jeu Linux créé en 1998 par Jochen Voss. C'est un jeu en mode ASCII, au principe très simple : vous conduisez une jeep sur la Lune, vous devez sauter par-dessus les cratères et détruire les obstacles avec votre laser.
Je l'ai installé avec APT, ce qui me permet de récupérer uniquement le programme compilé, sans le code source :
sudo apt install -y moon-buggy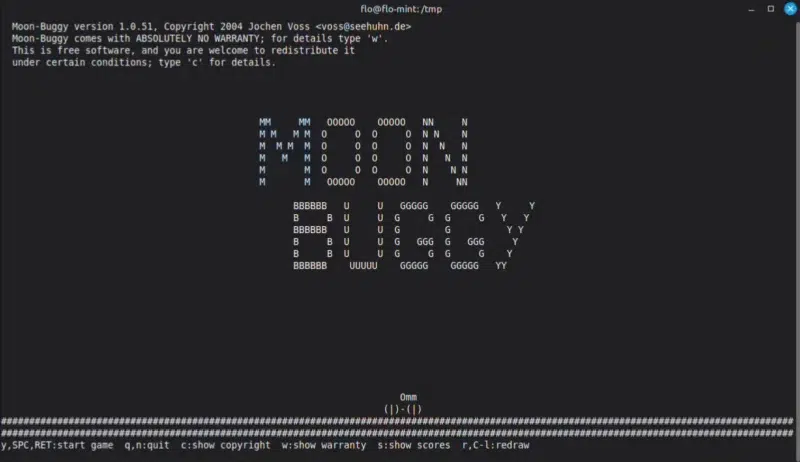
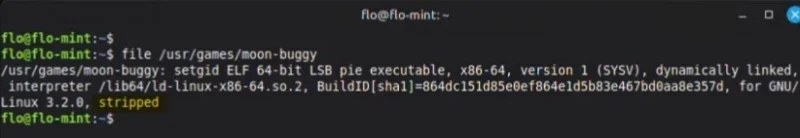
Si l'on inspecte ce fichier avec la commande file, un mot attire l'attention : stripped.
file /usr/games/moon-buggy

/usr/games/moon-buggy: setgid ELF 64-bit LSB pie executable, x86-64, version 1 (SYSV), dynamically linked, interpreter /lib64/ld-linux-x86-64.so.2, BuildID[sha1]=..., for GNU/Linux 3.2.0, stripped
Qu'est-ce qu'un binaire stripped ? Un binaire « stripped » a été nettoyé de ses symboles de débogage lors de la compilation ou du packaging. Les noms des fonctions et des variables internes ont disparu, ce qui complique l'analyse.
Le prompt envoyé à Claude Code
Voici la demande que j'ai envoyée à Claude Code. Elle comporte deux parties : retrouver les règles du jeu, avec une preuve pour chaque règle, puis recréer le jeu dans une page web.
Contexte : démonstration pour un tutoriel IT-Connect sur REA. moon-buggy est un jeu
open source (GPL) installé via apt. Je n'utilise que le binaire, sans le code source,
pour montrer ce que la rétro-ingénierie assistée par IA permet de comprendre.

Utilise REA pour analyser /usr/games/moon-buggy. Retrouve les règles du jeu à partir
de l'analyse : vitesse de défilement, saut (durée, hauteur), types d'obstacles,
calcul du score et détection des collisions. Pour chaque règle, montre la preuve
(fonction, adresse, instructions ou constantes). Indique clairement ce qui reste
incertain.

Ensuite, recrée le jeu dans un fichier index.html autonome, jouable au clavier,
en appliquant les règles retrouvées.
Quelques remarques sur ce prompt, car sa formulation influence directement la qualité du résultat :
Le contexte indique à l'agent pourquoi l'analyse est menée et dans quel cadre.
La liste des règles attendues cadre l'investigation et évite que l'agent se disperse.
L'exigence de preuve oblige l'agent à s'appuyer sur ce que REA lit dans le binaire.
La demande d'incertitudes l'encourage à distinguer ce qui est démontré de ce qui est supposé.
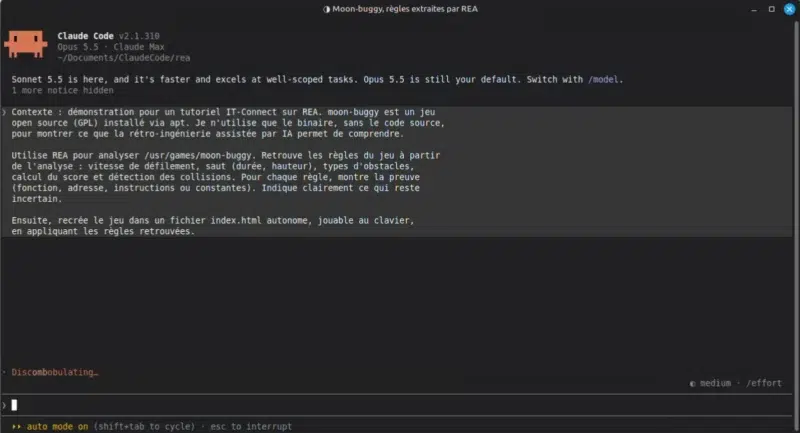
Sur d'autres tests effectués par mes soins, il y a eu un blocage par les garde-fous d'Anthropic, notamment sur des analyses un peu trop orientées cybersécurité. Le contexte est important, et il n'est pas à exclure que Claude Opus 5.5 ne soit pas toujours autorisé en fonction de ce que vous cherchez à effectuer avec REA.
L'agent au travail : chaînes, fonctions et Ghidra
L'agent commence par charger la skill reverse-engineer-anything installée par REA, puis se met au travail. Il ouvre le binaire, constate qu'il est stripped (97 fonctions sans nom), et part des chaînes de caractères pour localiser la logique du jeu : score_crater, level_start, lives: %d, etc. Il remonte ensuite jusqu'aux fonctions qui utilisent ces chaînes, lance Ghidra via REA pour les décompiler, et analyse leurs instructions.
Au fil de l'analyse, il annonce ses découvertes : la boucle principale de défilement, une table de 13 sprites du buggy, une table de 8 niveaux, la machine d'états du saut, la fonction qui gère le laser, etc. Chaque élément est associé à une adresse ou à une fonction (FUN_0010bc60, 0x116e60, etc.).
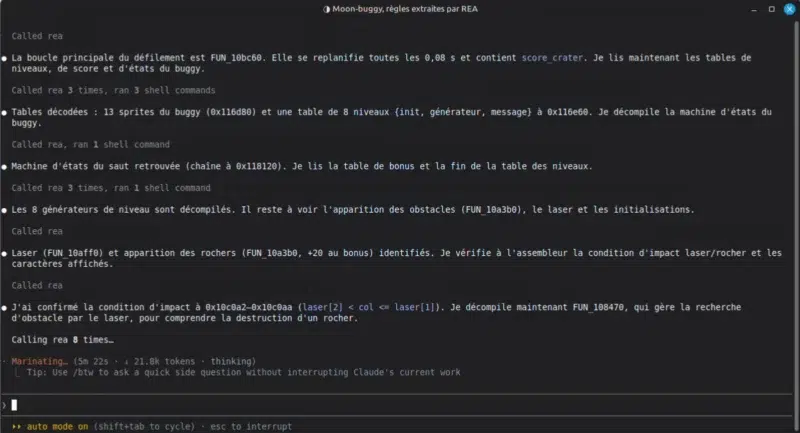
Au total, ce travail de rétro-ingénierie mené par Claude Code (avec le modèle Opus 5.5) et REA, de l'analyse jusqu'à la création de la version web, a pris 12 minutes et 29 secondes.
Les règles retrouvées et leurs preuves
Voici les règles identifiées par l'agent, telles qu'il les a restituées dans la version web du jeu (les preuves détaillées, adresse par adresse, sont consignées dans un rapport à part : ANALYSE.md) :
Règle
Ce que l'agent a retrouvé
Défilement
Le sol avance d'une colonne toutes les 0,08 s
Saut
5 états, 1,08 s au total, dont 0,88 s sans contact avec le sol, et 2 lignes de hauteur au maximum
Obstacles
Cratères de 1 à 6 de large, et « rochers » qu'il faut toucher 3 fois au laser pour les détruire
Score
Bonus selon la largeur du cratère, bonus d'enchaînement, +20 pour un obstacle franchi, +13 pour un obstacle détruit, -1 par tir
Collisions
Le buggy est perdu si une roue passe au-dessus d'un trou, ou s'il touche un obstacle au niveau du sol. 3 vies et 8 niveaux
L'agent IA a aussi listé ce qui restait incertain, avec un listing proposé au moment de la restitution.
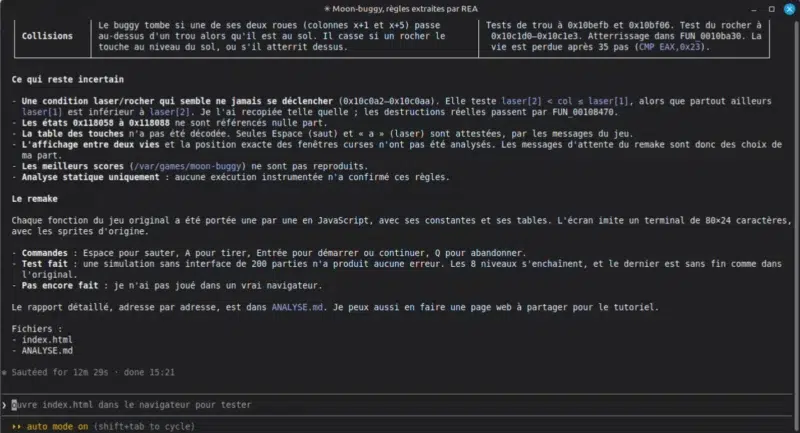
Ce qui est intéressant, c'est que toutes les règles identifiées par l'IA sont exactes, jusqu'aux durées du saut. Seul petit détail : ce que l'IA appelle des « rochers » sont en réalité des météorites dans le code source. Une erreur de vocabulaire qui n'est pas surprenante, puisque les noms d'origine avaient disparu du binaire.
Moon-Buggy recréé en version web
Il ne reste plus qu'à ouvrir le fichier index.html généré par l'agent dans un navigateur. Le jeu est jouable au clavier (Espace pour sauter, A pour tirer, Entrée pour démarrer ou continuer, Q pour abandonner), et la page affiche en bas la liste des règles appliquées, avec un renvoi vers les preuves.
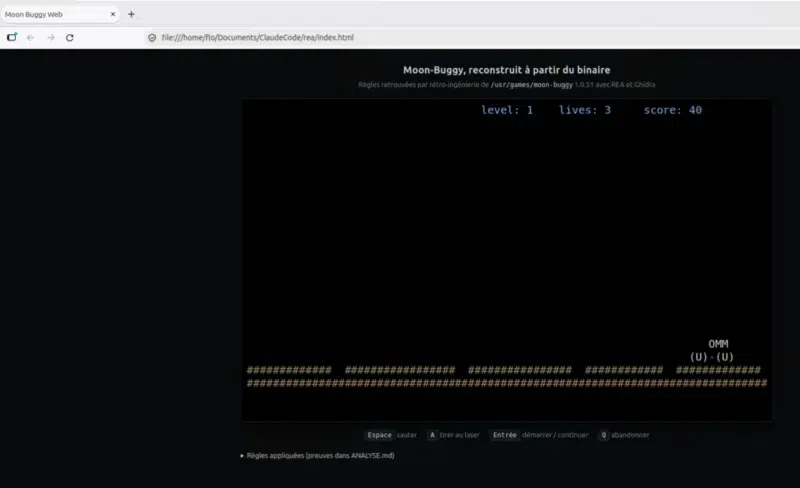
La version web et la version console offrent la même expérience de jeu, l'une dans le navigateur web, l'autre dans le terminal !
Claude avec ou sans REA
REA est plein de belles promesses, mais il faut garder la tête froide : un agent comme Claude, sans REA, peut faire un travail similaire. Il dispose déjà d'outils classiques sous Linux et sait lire de l'assembleur. Il mettra simplement plus de temps à atteindre le même objectif, car il n'est pas branché sur Ghidra ou sur un autre moteur d'analyse via le serveur MCP de REA.
Autrement dit, REA est de l'outillage pour la rétro-ingénierie, rien de plus et rien de moins. Il apporte :
Un accès structuré aux moteurs d'analyse (Ghidra, IDA, Hopper, JADX...) sans avoir à les manipuler soi-même.
Une méthode d'investigation via la skill installée dans l'agent.
Des résultats traçables, avec des preuves et des zones d'incertitude explicites.
Si REA connaît un tel succès aujourd'hui, ce n'est pas un hasard : il rend la rétro-ingénierie accessible, et cela attire beaucoup de curieux qui veulent voir comment reproduire telle ou telle application. Quoi que vous fassiez avec REA, pensez au cadre légal : lui ne change pas.
Conclusion
REA ne réinvente pas la rétro-ingénierie : il la rend pilotable par un agent IA, en s'appuyant sur des outils éprouvés comme Ghidra. REA apporte une méthodologie de travail et facilite l'accès à des outils spécifiques, contrairement à Claude seul que vous devez pleinement guider.
Je pense sincèrement que ce type d'outillage va changer la façon dont on aborde l'analyse de binaires, que ce soit pour la recherche de vulnérabilités, l'analyse de malwares, la préservation logicielle ou l'interopérabilité de matériel sous Linux.
Pour aller plus loin :
Ghidra sur GitHub et sur son site officiel
Ajouter IT-Connect à mes
sources préférées
Cofondateur d'IT-Connect et Microsoft MVP "Cloud and Datacenter Management". Mon obsession depuis près de 15 ans ? Rendre l'administration système et la cybersécurité accessibles, que vous soyez junior ou confirmé. Plus qu'un métier, l'IT est pour moi une véritable passion. J’accompagne au quotidien les sysadmins et les professionnels de l’IT dans leur montée en compétences et leur veille technique.