GPT-6 Astra a touché 0,016 % des poids de Qwen : son score en maths est multiplié par 6
De 7,9 % à 48,1 % sur le benchmark MATH-500 : c'est le bond réalisé par le petit modèle Qwen3.5-0.8B après une retouche de ses poids effectuée par GPT-6 Astra, sans aucune phase d'entraînement. Voici ce qu'il faut retenir de cette expérience menée au MIT.
Le 2 novembre 2026, quatre chercheurs du MIT CSAIL, Rikiya Takehi, Jayden Teoh, Alex Zhang et Omar Khattab, ont publié un rapport de recherche intitulé Sparks of Weight-Space Programming. Leur idée : demander à un LLM de lire et d'écrire directement les poids d'un autre réseau de neurones, à partir d'un objectif formulé en langage naturel. Le tout sans utiliser une boucle d'entraînement. Cette technique porte un nom : le Weight-Space Programming.
Le modèle mis à contribution pour accomplir cette tâche n'est autre que GPT-6 Astra, le modèle phare d'OpenAI (en tout cas, actuellement). C'est le modèle le plus performant dans le catalogue d'OpenAI et OpenAI a volontairement bridé la version publique en raison de ses capacités offensives en cybersécurité. D'après les journaux des expériences publiés sur GitHub, Astra a été appelé via Codex CLI avec tous ses outils intégrés désactivés. Quand une expérience l'autorisait à écrire du code Python, ce sont les chercheurs qui l'exécutaient, dans un bac à sable.
Qwen3.5-0.8B : des boucles de réflexion fortement réduites en modifiant 0,016 % des poids
La technique employée par les chercheurs a eu des effets très intéressants sur Qwen3.5-0.8B, le genre de petit modèle que l'on fait tourner en local sur une machine modeste. Et pourtant, ce modèle a un défaut connu, documenté par l'équipe Qwen elle-même. "En mode réflexion, nous avons observé qu'avec les paramètres d'échantillonnage recommandés, Qwen3.5-0.8B est plus enclin à entrer dans des boucles de réflexion que les autres modèles Qwen3.5, ce qui peut l'empêcher de terminer correctement sa génération.", peut-on lire sur sa fiche Hugging Face.
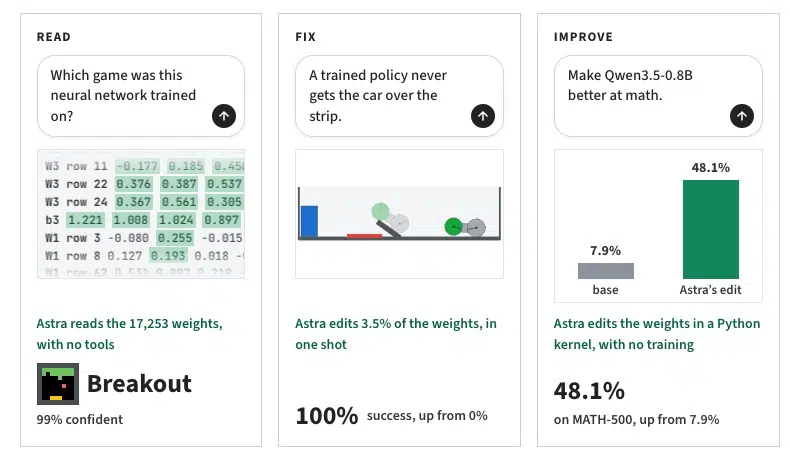
Dans le cas de ces expériences, Astra pouvait inspecter les poids de Qwen avec du code Python (sans GPU) et piocher dans des exercices de maths tirés de GSM8K et de MATH (pas ceux des tests). Il pouvait aussi faire tourner le modèle un nombre limité de fois pour observer ses réponses : chaque « passe » permettait de lui soumettre jusqu’à 512 problèmes. En analysant ces réponses et les poids, Astra a localisé l’origine des boucles : un même signal, injecté par deux des 24 couches du modèle (les couches 15 et 19). Il a ensuite retiré ce signal à la source, en corrigeant une petite partie des poids de ces deux couches. Bilan de la manipulation : 131 072 poids modifiés sur 0,8 milliard.
Ainsi, avec un budget de 50 passes, voici les résultats qui mettent en valeur la progression importante obtenue :
MATH-500 : de 7,9 % à 48,1 %
GSM8K : de 13,8 % à 67,1 %
IFEval (suivi d'instructions) : de 21,0 % à 62,3 %
Réponses tronquées à la limite de 32 768 tokens sur MATH-500 : de 93 % à 33,1 %
Le dernier chiffre est le plus parlant : le modèle d'origine tournait en rond dans l'immense majorité des cas.
Lire, réparer et écrire des réseaux de neurones
Le rapport des chercheurs détaille d'autres expériences, menées pour la plupart sur de toutes petites IA (des réseaux de neurones de quelques dizaines à quelques centaines de milliers de poids). Ces mini-IA ont été entraînées à jouer à des jeux vidéo rétro comme Breakout ou Pong, ou à piloter une voiture dans un simulateur physique. Ce sont des terrains de test classiques en recherche, car on peut mesurer précisément si l'IA réussit ou non.
Voici ce qu'Astra a obtenu :
Deviner à quoi sert une IA : en lisant seulement les poids de quatre mini-IA entraînées sur des jeux différents (des versions simplifiées de Breakout, Pong, Pac-Man et Freeway), Astra a trouvé le bon jeu à chaque fois, sans qu'on lui donne la liste.
Réparer une IA qui échoue : une IA chargée de piloter une voiture virtuelle restait bloquée sur une rampe. Astra a modifié 3,5 % de ses poids, et la voiture a réussi le parcours à tous les essais.
Créer une IA de toutes pièces : sans entraînement, Astra a écrit lui-même les poids d'une IA joueuse. Sur Breakout, elle fait 20 fois mieux qu'une IA entraînée de façon classique. Sur deux autres jeux, elle reste derrière.
Repérer une IA complaisante : Astra devait distinguer deux copies d'un petit modèle de langage, dont l'une avait été entraînée à toujours donner raison à l'utilisateur. Les poids seuls ne lui ont pas suffi. Il y est parvenu en observant sur quels mots chaque modèle concentrait son attention.
Une avancée prometteuse
Les chercheurs ont publié un contre-exemple. Sur Gemma 3 270M, un modèle qui boucle rarement (8,5 % de réponses tronquées), Astra n'a pas réussi à améliorer le score MATH-500 : 7,7 % au mieux, contre 6,8 % au départ. "Modifier les poids pouvait lever un obstacle qui masquait une capacité, mais ne pouvait pas ajouter une capacité dont le modèle était dépourvu.", reconnaissent les auteurs de ces travaux. Autrement dit, Astra n'a pas rendu Qwen « meilleur en maths » : il a fortement réduit un comportement parasite qui l'empêchait de conclure. C'est déjà intéressant, mais ce n'est pas la même chose.
Il y a aussi des perspectives pertinentes côté cybersécurité. En effet, les auteurs évoquent l'audit d'un modèle directement à partir de ses poids, par exemple pour y détecter une porte dérobée. Mais la logique fonctionne aussi dans l'autre sens : un modèle capable de retoucher des poids de façon aussi chirurgicale pourrait, en théorie, y glisser un comportement discret... C'est un risque, à voir si nous aurons des cas avérés à l'avenir... Nous ne sommes surement pas au bout de nos surprises.
Ajouter IT-Connect à mes
sources préférées
Cofondateur d'IT-Connect et Microsoft MVP "Cloud and Datacenter Management". Mon obsession depuis près de 15 ans ? Rendre l'administration système et la cybersécurité accessibles, que vous soyez junior ou confirmé. Plus qu'un métier, l'IT est pour moi une véritable passion. J’accompagne au quotidien les sysadmins et les professionnels de l’IT dans leur montée en compétences et leur veille technique.