Claude Code : à quoi sert la commande /compact et quand l’utiliser à la main
Dans cet article, nous allons voir à quoi sert la commande /compact de Claude Code, quel problème elle résout, et surtout pourquoi il peut être intéressant de la déclencher à la main plutôt que d'attendre que l'outil le fasse automatiquement.
Si vous utilisez Claude Code au quotidien, vous avez forcément déjà vu apparaitre le message Context left until auto-compact: 12% dans le coin de votre terminal, parfois ce message empêche de faire quoi que ce soit pendant plusieurs minutes. Derrière ce petit indicateur se cache une mécanique à connaitre : celle de la gestion de la fenêtre de contexte du modèle, qui conditionne à la fois la qualité de ses réponses, le coût de la session et parfois même la poursuite du travail en cours.
Nous verrons dans cet article pourquoi une session Claude Code finit par saturer, comment fonctionne la compaction automatique proposée par l'outil, et dans quels cas vous auriez tout intérêt à lancer /compact vous-même avec des instructions sur mesure.
Comprendre le problème : la saturation du contexte
Qu'est-ce que la fenêtre de contexte ?
Avant de parler de compaction, un petit rappel s'impose. Un LLM (Large Language Model) comme Claude ne "se souvient" pas de vos échanges, à l'inverse d'un humain. À chaque fois que vous lui posez une question, l'intégralité de la conversation précédente est renvoyée au modèle en entrée, pour qu'il puisse générer une réponse cohérente avec ce qui a été dit avant.
Cette quantité d'information que le modèle peut ingérer en une seule fois est mesurée en tokens (en gros, des fragments de mots) et porte un nom : la fenêtre de contexte. Elle est finie : pour la famille Claude actuelle, on parle de centaines de milliers de tokens, ce qui est confortable, mais pas infini.
Un token correspond en moyenne à 3 ou 4 caractères en français. Une fenêtre de 200 000 tokens représente donc l'équivalent de plusieurs centaines de pages de texte, ce qui semble énorme… jusqu'au moment où l'on commence à y verser des fichiers de code entiers et des sorties de commande.
Dans Claude Code, cette fenêtre héberge en vrac : vos messages, les réponses du modèle, le prompt système, le contenu de votre fichier CLAUDE.md, les définitions des outils, les skills chargées, et bien sûr tout le résultat des commandes que l'agent exécute pour vous.
Pourquoi une session Claude Code grossit vite
Dans les faits, une session un peu nourrie remplit sa fenêtre plus vite qu'on ne l'imagine. Chaque fois que l'agent lit un fichier, lance une commande shell, inspecte un dépôt Git ou interroge un serveur MCP (Model Context Protocol), le résultat vient s'empiler dans l'historique. Et comme nous l'avons dit, cet historique est renvoyé au modèle à chaque échange.
Prenons un exemple. Dans mon cas, je demande à Claude Code d'auditer un petit projet Python :
# Commandes typiques qu'un agent va enchaîner sur un audit
ls -R
cat requirements.txt
cat src/*.py
grep -r "password" .
python -m pytest -v
En trois ou quatre échanges, l'agent a potentiellement injecté plusieurs milliers de lignes dans son propre contexte. Si l'on ajoute à cela les lectures d'autres fichiers, les tentatives de correction, les retours de tests qui échouent et qui sont relancés, on comprend pourquoi la taille du contexte augmente vite.
Également, certaines sources sont particulièrement gourmandes :
Les sorties d'un outil verbeux ou une stack trace.
Les logs applicatifs récupérés via
tailoujournalctl.Les gros fichiers JSON ou YAML lus intégralement.
Les définitions d'outils MCP quand plusieurs serveurs sont connectés.
La commande
/contextest votre meilleure amie pour visualiser qui mange quoi dans la fenêtre. Elle affiche la répartition entre le prompt système, les skills, les serveurs MCP, le fichierCLAUDE.mdet la conversation en cours. Je vous recommande de l'exécuter de temps en temps, surtout si vous trouvez qu'une session "ralentit".
Les symptômes d'une session saturée
Comment reconnaître qu'une session commence à atteindre ses limites ? Plusieurs signaux peuvent vous mettre la puce à l'oreille :
Le modèle oublie des consignes données en début de session ou mélange des éléments qui n'ont rien à voir.
Les réponses deviennent plus génériques, moins cohérentes ou précises.
Les coûts grimpent sans raison apparente, puisque chaque nouvelle requête embarque une conversation de plus en plus lourde.
La vitesse de réponse diminue, le modèle devant traiter davantage de tokens en entrée.
Voici un exemple de sortie de la commande /context pour une discussion bien chargée :
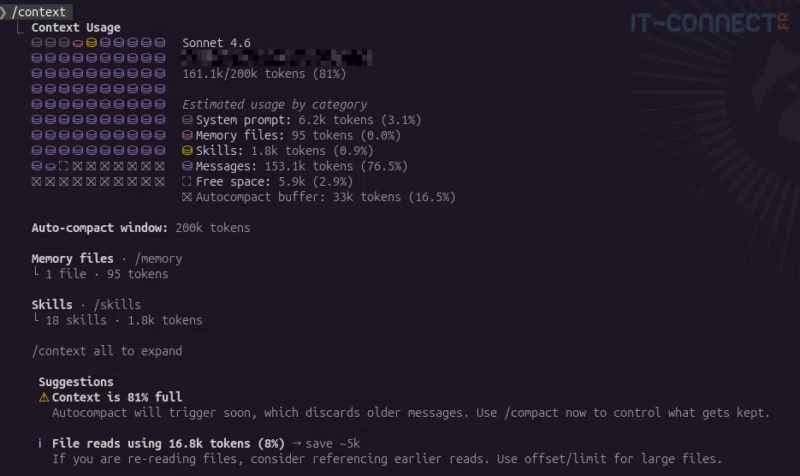
Affichage de la commande /context dans Claude Code, avec la répartition de la fenêtre de contexte par catégorie.
Bref, un contexte trop plein n'est pas qu'une question de confort : cela dégrade progressivement la qualité du travail. C'est précisément là qu'intervient la compaction.
Le principe du résumé en place
L'idée de la compaction est que, plutôt que de laisser la session mourir d'étouffement, Claude Code remplace l'historique complet par un résumé condensé généré par le modèle lui-même. Vous continuez à travailler dans la même session, avec le même contexte apparent, mais sous le capot, les 150 derniers messages ont été remplacés par quelques milliers de tokens de synthèse.
La compaction préserve en principe les éléments importants : décisions prises, fichiers manipulés, erreurs rencontrées, prochaine étape prévue. Elle réinjecte aussi la dernière invocation de chaque skill utilisée (dans la limite d'un budget total d'environ 25 000 tokens), afin de ne pas perdre les contextes spécialisés chargés en cours de route.
Attention toutefois, les skills les plus anciens peuvent être purement et simplement abandonnés lors d'une compaction si beaucoup ont été invoqués pendant la session. Si vous travaillez avec plusieurs skills et que l'une d'elles vous est indispensable pour la suite, pensez à la réinvoquer explicitement après la compaction.
Le seuil de déclenchement
Par défaut, Claude Code déclenche la compaction automatiquement lorsque la fenêtre de contexte approche de son plafond. Vous verrez en bas de votre terminal un indicateur qui descend progressivement :
# Message d'avertissement qu'un auto-compact est proche
Context left until auto-compact: 23%
Lorsque ce seuil est franchi, la compaction se déclenche de manière transparente : vous verrez un message indiquant que la conversation est en cours de résumé, puis la session reprend normalement. Vous n'avez rien à faire.
Dans l'immense majorité des cas, cela fonctionne très bien. Si vous êtes en train d'enchaîner un travail long et répétitif (un gros refactor, une génération de tests sur plusieurs modules), vous pouvez très bien laisser Claude Code gérer tout seul.
Les limites de l'auto-compaction
Alors, si l'automatisme fonctionne bien, pourquoi s'embêter à déclencher /compact à la main ? Pour deux raisons principales.
Premièrement, l'auto-compaction se déclenche tard, au moment où la fenêtre est quasi pleine. Or, plus l'historique à compacter est long, plus l'opération de résumé elle-même coûte cher en tokens : le modèle doit lire tout ce qu'il va résumer avant de produire sa synthèse. Un /compact déclenché à la main plus tôt sur un historique moins volumineux est donc moins long et coûteux.
Deuxièmement, et c'est à mon sens le point le plus important : vous ne contrôlez pas ce que le modèle choisit de garder. L'auto-compaction fait au mieux avec une consigne générique. Si votre session contient un mélange de sujets (du debug, de la relecture de documentation, puis une implémentation en cours), le résumé automatique peut très bien "diluer" ce qui vous importait vraiment, et donc réduire son importance, voire dans le pire des cas, l'oublier.
C'est notamment vrai quand, au cours d'un échange long, vous changez de périmètre, de façon de travailler ou passer d'une solution qui n'a pas fonctionné à une autre plus efficace. Il n'apparait alors pas utile de garder certains éléments lors de la compaction.
C'est ici qu'une invocation manuelle de /compact prend tout son sens.
Utiliser /compact à la main : les cas d'usage
Syntaxe et comportement de la commande
On passe à la pratique, la commande se tape directement dans l'invite de Claude Code, et s'utilise de façon simple :
# Compaction standard, sans directive particulière
/compact

# Compaction orientée, avec une directive de ce qu'il faut conserver
/compact Focus sur les décisions d'architecture et le schéma de la base
Dans le premier cas, Claude Code produit un résumé générique de la conversation. Dans le second, le modèle utilise votre directive pour pondérer ce qu'il juge important de retenir. Les éléments cités dans la directive seront prioritaires dans le résumé, les autres pourront être réduits à quelques lignes voire omis.
Après l'exécution, vous retrouverez votre invite habituelle avec une fenêtre de contexte très largement libérée. La conversation continue, mais le modèle "voit" désormais un résumé à la place de l'historique brut. Voici la fenêtre de contexte de la même conversation après compaction :
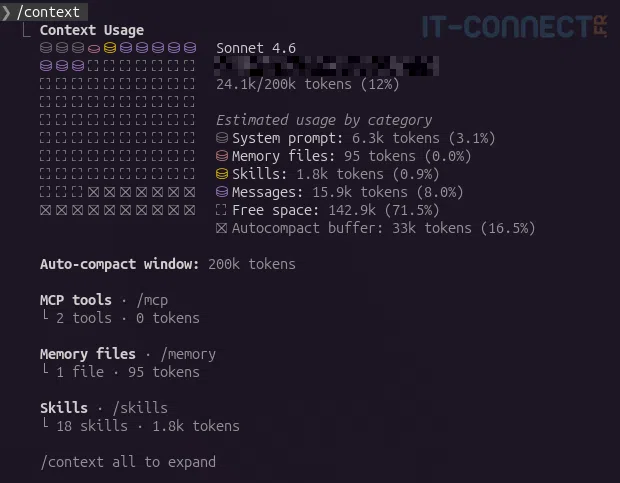
Affichage de la commande /context dans Claude Code, après compaction.
Compacter avant un changement de phase
Le cas d'usage le plus utile de la commande manuelle, c'est le changement de phase. Imaginez une session où vous venez de passer une heure à chasser un bug dans une API. Le bug est corrigé, les tests passent. Vous voulez maintenant basculer sur la rédaction de la documentation de cette même API.
L'historique de la session contient à ce stade pleins d'informations:
Toutes les tentatives de reproduction du bug.
Les lectures de fichiers successives.
Les sorties de tests qui échouaient.
Les patchs intermédiaires.
Nous n'avons plus besoin de tout cela pour écrire la documentation. Ce qui nous intéresse, c'est le comportement final de l'API, pas le chemin tortueux pour y arriver. Un /compact ciblé est très utile à ce moment-là :
# Préparer la session pour la phase suivante
/compact Garde uniquement le comportement final de l'API, les noms des endpoints, et les cas d'erreur à documenter. Oublie les tentatives de debug.
Le modèle produira alors un résumé sain et beaucoup plus utile pour la suite, et vous repartez sur une base propre, dans la même session.
Ce que j'appelle changement de phase est donc un changement qui peut être l'occasion de dire à Claude "OK, maintenant on se focus là-dessus, donc optimises tes souvenirs pour cela".
Guider le résumé avec des instructions ciblées
Je vous l'ai un peu montré dans l'exemple précédent, mais sachez que plus votre directive de compaction est spécifique, meilleur sera le résultat. Quelques formulations qui fonctionnent bien d'après mon expérience :
# Prioriser certains fichiers
/compact Conserve l'intégralité des décisions prises sur `src/auth/` et oublie le reste.

# Prioriser un livrable
/compact Je dois pouvoir reprendre la rédaction du Dockerfile sans contexte annexe.

# Prioriser des erreurs vues
/compact Garde les messages d'erreur rencontrés et les contournements appliqués.
Le modèle respecte généralement très bien ces consignes. Il faut noter que la directive de /compact ne "commande" pas le travail à venir : elle oriente uniquement ce que le modèle doit retenir du passé. Ne vous attendez pas à ce qu'elle serve de nouvelle feuille de route pour la suite de la session, c'est un autre sujet.
/compact ou /clear : différence importante
Il existe une commande voisine, /clear, qui elle vide complétement l'historique et redémarre une session à blanc. La différence est importante et il faut la connaitre pour éviter d'écraser tout son travail :
Commande
Effet
Quand l'utiliser
/compact
Résume l'historique, conserve une continuité
Même sujet, mais la session devient trop lourde
/clear
Supprime l'historique, repart de zéro
Changement total de sujet, nouveau projet
Dans mon cas, j'ai pris l'habitude de me poser une question simple avant de choisir : "Est-ce que je veux encore que Claude se souvienne de quelque chose de ce qui précède ?". Si la réponse est oui, même partiellement, c'est /compact. Si la réponse est non, autant basculer en /clear, qui ne consomme rien, là où /compact coûte un résumé de tout le contexte actuel.
Pour finir, l'intérêt de /clear est de redémarrer une conversation saine en gardant, par exemple, le prompt système lu à l'initialisation, le CLAUDE.md, les skills, outils et MCP configurés, etc.
Automatiser le comportement via CLAUDE.md
Dernière astuce, et pas des moindres : vous pouvez définir une directive de compaction par défaut dans le fichier CLAUDE.md à la racine de votre projet. Claude Code lira ces instructions à chaque compaction, qu'elle soit manuelle sans directive ou automatique.
Voici un exemple de section que vous pouvez ajouter dans votre CLAUDE.md :
# Compact instructions

Lors d'une compaction, conserve en priorité :
- les décisions d'architecture validées par l'utilisateur
- les chemins de fichiers modifiés et le motif de la modification
- les commandes de build et de test qui fonctionnent
Oublie :
- les tentatives abandonnées
- les sorties verbeuses des outils
Cela vous évite d'avoir à retaper une directive à chaque appel. Pour un projet où vous travaillez régulièrement, cela permet d'uniformiser la façon dont la compaction sera faite d'une session à l'autre.
Attention à ne pas surcharger votre CLAUDE.md pour autant. Ce fichier est chargé dans le contexte à chaque démarrage de session, donc chaque ligne ajoutée consomme en permanence. Mieux vaut une directive de compaction concise que trois paragraphes détaillés.
Conclusion
Nous avons vu dans cet article comment fonctionne la fenêtre de contexte de Claude Code, ce que fait la commande /compact, et dans quels cas il peut être intéressant de la déclencher à la main plutôt que de s'en remettre à l'auto-compaction. En résumé : laissez l'automatisme gérer les sessions courtes et linéaires, mais utilisez /compact dès qu'il y a un changement de phase dans votre travail ou que vous voulez contrôler précisément ce qui est conservé.
La gestion du contexte est à mons avis l'une des compétences les plus sous-estimées quand on utilise un agent de code au quotidien. Prendre dix secondes pour taper /compact avec une bonne directive, peut faire la différence entre une session qui reste pertinente trois heures de plus et une session qu'il faut abandonner.
Il y a encore beaucoup à dire sur l'optimisation de l'usage de Claude Code (choix du modèle, skills, serveurs MCP…), mais nous aurons l'occasion d'y revenir dans d'autres articles.
N'hésitez pas à partager dans les commentaires vos propres habitudes de compaction, ou à venir en discuter sur notre serveur Discord.
Ajouter IT-Connect à mes
sources préférées
Co-fondateur d'IT-Connect.fr. Auditeur/Pentester chez Orange Cyberdéfense.